
Z.ai выпустила GLM-5.3-Flash — модель, которая по качеству близка к топовым ИИ, но пользоваться ею можно бесплатно прямо в чате Z.ai. Причём сервис работает и из России без ограничений и ВПН, а через API Flash-версия стоит в разы дешевле большинства флагманских моделей.
В этой статье покажем, как пользоваться GLM-5.3-Flash в чате Z.ai, подключить её через API и как запустить ИИ-модель локально.
Читайте также: Как пользоваться ИИ-агентом QwenWork
Как пользоваться нейросетью GLM-5.3-Flash
Самый простой вариант — открыть GLM-5.3-Flash в веб-версии Z.ai. Для разработки модель можно подключить через API, использовать в кодинговых инструментах Z.ai или скачать открытые веса с Hugging Face.
Способ 1. В чате Z.ai
Откройте чат Z.ai. В левом верхнем углу выберите GLM-5.3-Flash или GLM-5.3 и напишите запрос.

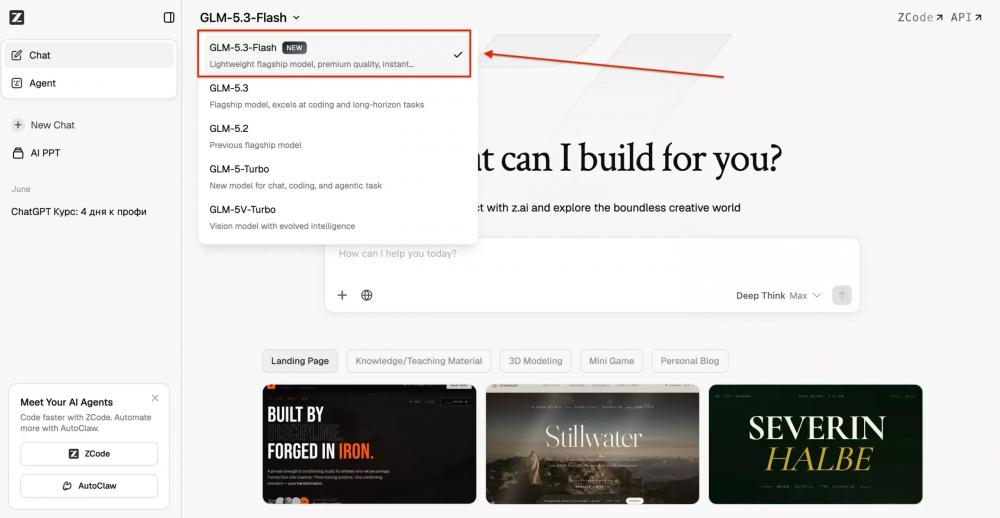
Перед отправкой запроса можно настроить режим работы модели. Для GLM-5.3-Flash доступны уровни усилия Low, High и Max. Режим Deep Think включён постоянно — отключить его нельзя.


Если для ответа нужны свежие или точные данные из интернета, нажмите значок глобуса. В обычном режиме модель выполнит быстрый поиск, а Advanced Search запустит более глубокий поиск в несколько этапов.


После этого ставьте задачу обычным текстом. Например:
- Статья: «Напиши статью о запуске нового ИИ-сервиса. Объясни, что он умеет, как им пользоваться и сколько это стоит».
- Пост: «Сделай короткий пост для Telegram по этой новости. Главное вынеси в первую строку».
- Сайт: «Сделай одностраничный сайт на HTML, CSS и JavaScript по этому описанию».
- Лендинг: «Напиши структуру лендинга для сервиса аналитики и текст для каждого блока».
- Код: «Проверь этот код, найди ошибки и предложи исправления».
- Таблица: «Проанализируй эту таблицу, найди аномалии и покажи главные изменения».
- Данные: «Сравни показатели за два периода и объясни, из-за чего изменился результат».
GLM-5.3-Flash Z.ai позиционирует как более дешёвую модель для тяжёлых задач: программирования, работы с инструментами, длинного контекста и многошаговых агентных сценариев. Поэтому её имеет смысл использовать не только для коротких ответов, но и там, где задача требует нескольких последовательных действий, анализа файлов или работы с кодовой базой.
Если задача связана именно с разработкой, GLM-5.3 и GLM-5.3-Flash также можно использовать через ZCode.
Статья в тему: Как настроить ИИ-агента в ChatGPT
Способ 2. Через API Z.ai
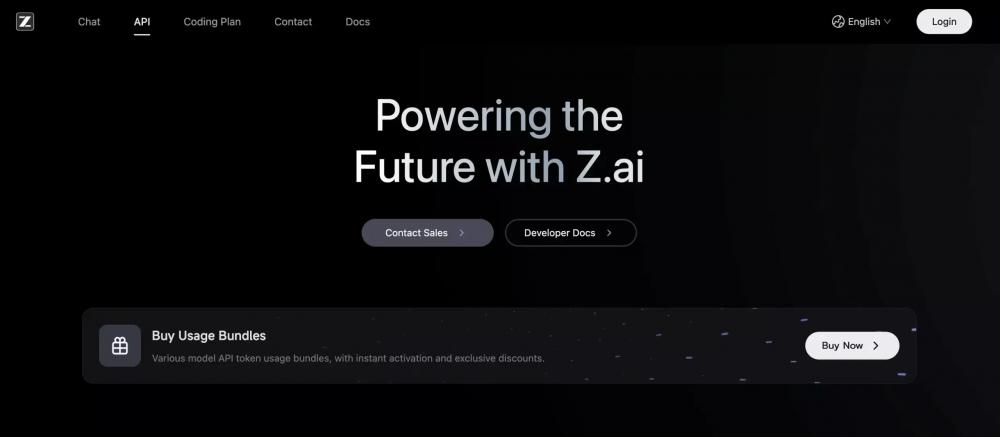
Для автоматизации GLM-5.3-Flash можно подключить через API. Сначала откройте платформу Z.ai API и войдите в аккаунт.

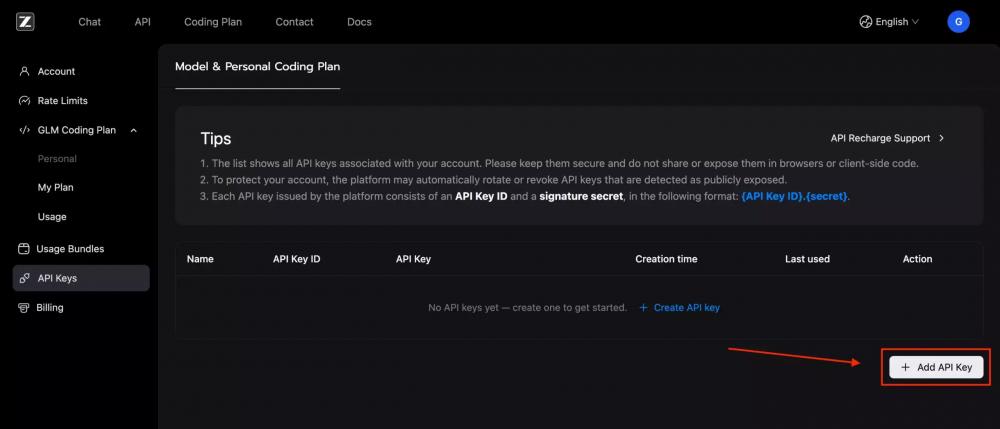
Затем перейдите в раздел API Keys и создайте ключ. Z.ai использует Bearer-аутентификацию, а основной адрес API — https://api.z.ai/api/paas/v4.

После этого GLM-5.3-Flash можно использовать в своём приложении либо подключить через OpenAI-совместимый API. Z.ai отдельно публикует примеры для Python, Java, cURL и OpenAI SDK.
Главное преимущество Flash-версии — цена. Стандартные тарифы:
- входные токены — $0,15 за 1 млн;
- кэшированный ввод — $0,03 за 1 млн;
- выходные токены — $0,50 за 1 млн.
При запуске Z.ai также объявила скидку 50% на первые две недели: соответственно $0,075, $0,015 и $0,25 за 1 млн токенов. По заявлению Z.ai, GLM-5.3-Flash обходится примерно в десять раз дешевле GLM-5.2, при этом превосходит её в собственных тестах компании.
Поэтому Flash имеет смысл использовать там, где запросов много, а постоянно отправлять их в более дорогую флагманскую модель невыгодно. Например, для обработки текстов, классификации, извлечения данных, простых операций с кодом, работы фоновых агентов и других массовых задач.
Для сложных запросов можно оставить GLM-5.3, а более предсказуемые и повторяющиеся операции отправлять в GLM-5.3-Flash. Так расходы на API снижаются без необходимости переводить весь продукт на более слабую модель.
Способ 3. Скачать GLM-5.3-Flash и запустить локально
GLM-5.3-Flash опубликована с открытыми весами по лицензии MIT. Скачать официальную версию можно на странице GLM-5.3-Flash на Hugging Face.

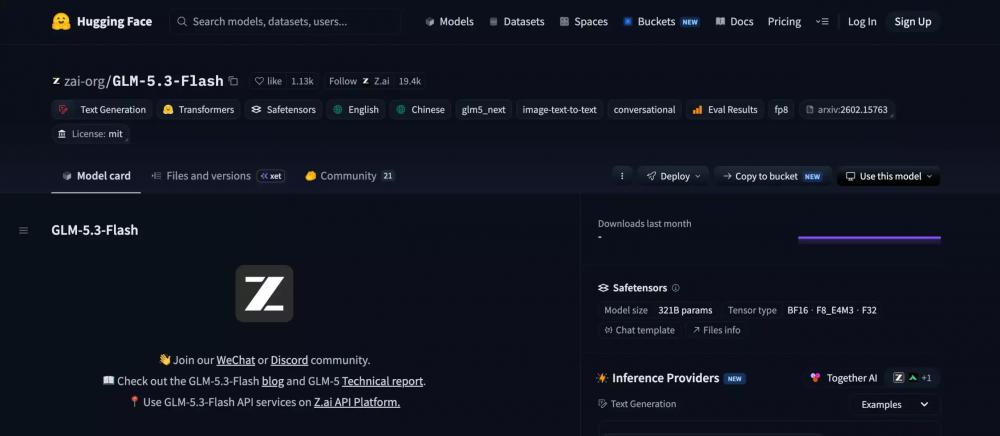
Несмотря на название Flash, это крупная модель: полный размер — около 320 млрд параметров. «18 млрд активных параметров» означает, что при обработке одного запроса используется только часть MoE-модели, а не то, что весь файл занимает столько же памяти, сколько обычная модель на 18 млрд параметров.
Поэтому исходные веса не рассчитаны на запуск на обычном ноутбуке или одной обычной видеокарте. Для локального запуска понадобятся серверные GPU или квантизированная версия с выгрузкой части модели в оперативную память.
Официально GLM-5.3-Flash поддерживает несколько вариантов запуска:
- SGLang;
- vLLM;
- TokenSpeed;
- KTransformers.
На Hugging Face также появились квантизированные сборки для llama.cpp, Ollama, LM Studio и других совместимых приложений.
Например, через vLLM модель запускается командой:
pip install vllm vllm serve "zai-org/GLM-5.3-Flash"
После запуска vLLM поднимает OpenAI-совместимый локальный API, к которому можно подключать приложения и агентов. Официальный пример Z.ai использует адрес http://localhost:8000/v1/chat/completions.
А что с обычной GLM-5.3?
GLM-5.3 остаётся старшей моделью Z.ai для задач, где важнее максимальное качество, чем стоимость одного запроса. Она ориентирована на сложное программирование и длительные агентные сценарии.
На момент публикации открытые веса GLM-5.3 на Hugging Face ещё не опубликованы. Мы обновим статью, когда они станут доступны.
Что делать дальше
Начните с веб-версии Z.ai и прогоните GLM-5.3-Flash на своих реальных задачах. Проверьте её на текстах, работе с кодом, длинном контексте и задачах, где агенту нужно выполнить несколько действий подряд.
Сравните результат с моделью, которой пользуетесь сейчас. Проверьте, какие задачи GLM-5.3-Flash выполняет без заметной потери качества. Массовые и повторяющиеся запросы, где качество сохраняется, переведите на неё. Отдельно посчитайте экономию в API: GLM-5.3-Flash стоит $0,15 за 1 млн входных и $0,50 за 1 млн выходных токенов, поэтому разница особенно заметна при большом потоке задач.
Больше гайдов по работе с ИИ:
- Как создать видео в MiniMax H3
- 15+ промтов для создания персонажа
- Как создавать изображения в MAI-Image-2.6


